· 月明Verse · 知识管理 · 11 分钟阅读
我用 AI 把知识库从「档案柜」变成「头脑地图」
**你的知识库问题不是存得太少,是从来没有「理解」过你存的东西。**
一句话核心观点
你的知识库问题不是存得太少,是从来没有「理解」过你存的东西。
先说我踩的坑
我搭知识库搭了三年。Notion、Roam、Obsidian 都用过,现在自己做了一套工具(ThirdSpace),有 300 多个 MD 文件,分了十几个主题,frontmatter 100% 规范,自动化备份,每晚定时刷新。
按理说应该很满意了。
但我最近发现一个问题:这 300 个文件,我只能「找到」,不能「理解」。
我知道某件事「存在某个文件里」。但我不知道「这件事和另一件事有什么关系」、「这个人在我生命里扮演了什么角色」、「我在遇到类似情况时有什么固定的反应模式」。
知识库变成了一个很整洁的档案柜。我是档案员,不是思考者。
问题出在哪
这几天看到一个 GitHub 上很火的 Skill(470 stars,昨天刚发布),作者 farzaa 写了一套把个人数据编译成知识 wiki 的方法论。
他开头第一句话把我打醒了:
“Not a filing clerk. A writer. Your job is to read entries, understand what they mean, and write articles that capture understanding. The wiki is a map of a mind.”
不是归档员,是作家。
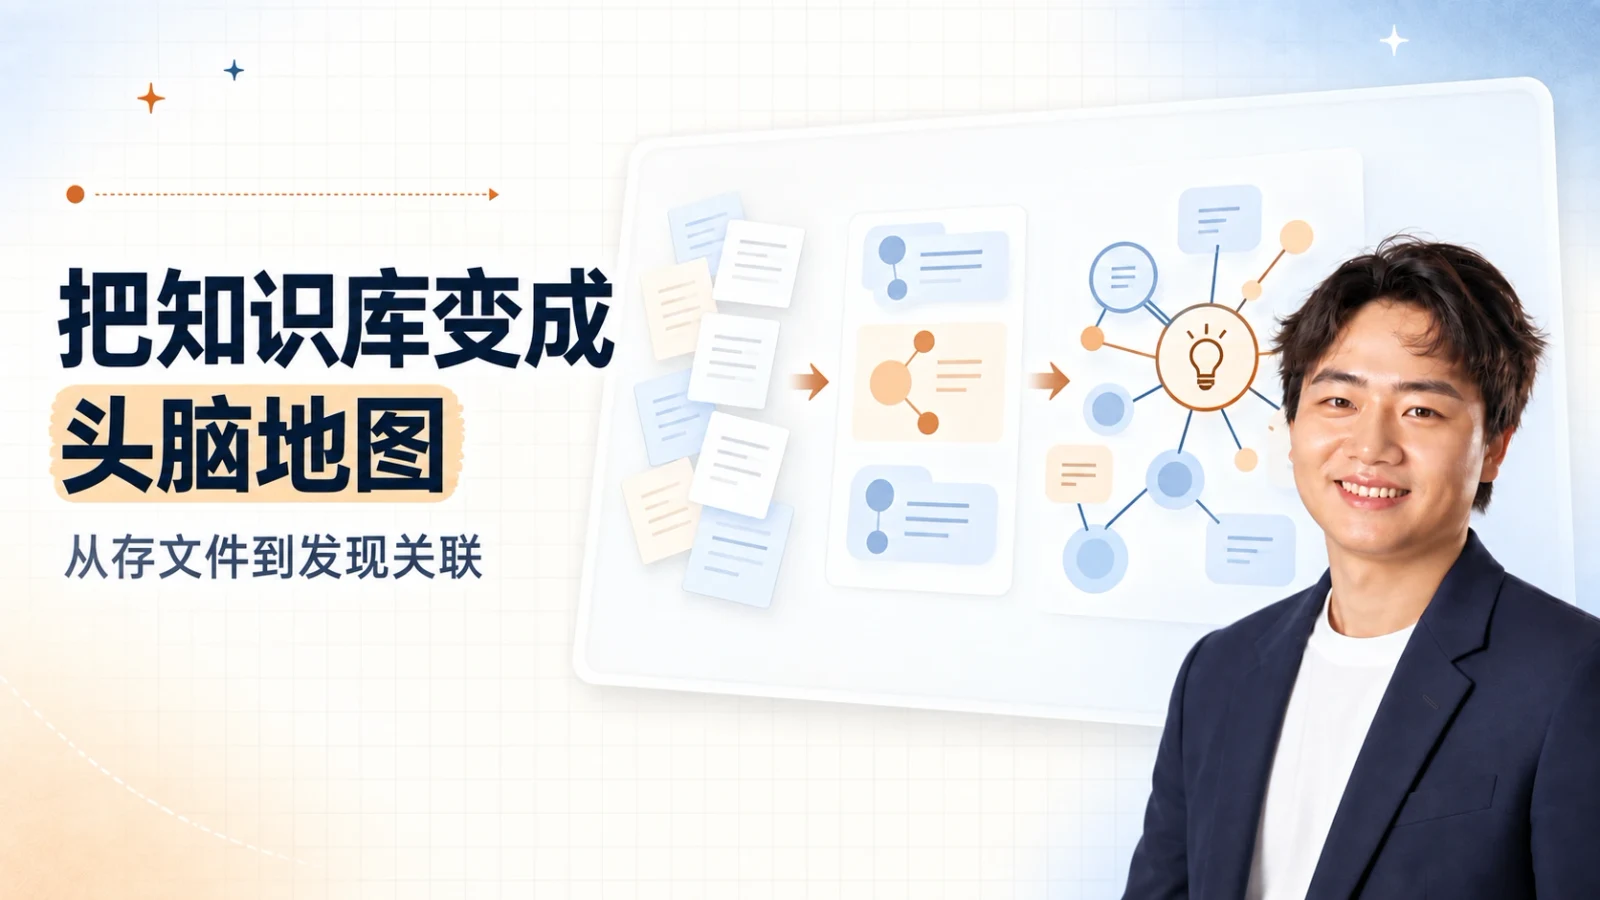
我意识到我的知识库一直在做的事情是「归档」——把信息放进正确的格子里。而真正有价值的知识库应该做的事情是「理解」——把碎片信息读懂,重新写成文章,织成一张网。
这两件事的差距,就是「档案柜」和「头脑地图」的差距。
档案柜 vs 头脑地图
具体说,我的知识库现在是这样的:
关于某个人 A:
  - events/2026-03-05_和A的谈话.md
  - events/2026-03-18_A提了个需求.md
  - events/2026-04-01_和A的冲突.md
  - people.json 里一条 interaction_summary:"沟通风格直接,注重结果"
三篇独立的事件文件,一条薄薄的总结。每次和 A 打交道之前,我要把三篇文件都翻出来读一遍,然后自己在脑子里重新合成理解。
头脑地图应该是这样的:
people/A.md

## 关系阶段
## 核心特质(有具体事件支撑)
## 对我决策的影响
## 关键转折点
一篇综合的理解文章。不是事件的时间线,是我对这个人的完整认知。
再比如,我最近在关注「本地 AI」这个方向。我的知识库里有:
- 20 多张关于 AI 的知识卡片(收藏的文章)
- 几篇工作日志里的碎片想法
- 两篇产品笔记
这些内容从来没有被合并过。它们之间的关联,只存在于我脑子里,不存在于知识库里。
这个方法论说了什么
farzaa 的 wiki skill 核心是一个问题的替换:
把「我把这条信息放在哪里?」
换成「这条信息是什么意思,它和我已经知道的东西有什么连接?」
听起来很简单,但实际上是完全不同的操作。
前者是分类(O(1) 操作,找个格子放进去)。
后者是理解(需要读懂已有内容,找到新的关联,重新改写文章)。
他的方法把知识组织分成了两层:
第一层:原始数据流(raw/entries/) 每条日记、每篇笔记、每次对话记录,原样保存,不加工。就像我的 worklog 和知识卡片,只负责「捕获」。
第二层:理解文章(wiki/) 按「实体 + 意义」组织,不按「时间 + 主题」组织。一个人一篇文章,一个项目一篇文章,一种行为模式一篇文章。每次有新的原始数据,不是「新建文件」,而是「更新已有文章的理解」。
两层之间的转化,不是归档,是吸收(absorb)——把原始数据读懂,织进已有的理解网络里。
我从中借鉴了三件事
第一件:人物「合并提炼」
以前:每次 LifeOS 事件单独一篇文件,people.json 里一条薄薄的总结。
现在计划:某个人积累了 3 篇以上事件后,写一篇综合的「人物理解文章」。不是时间线,而是:
- 他的核心行事风格(有具体场景支撑)
- 他的动机和关注点
- 这段关系对我的影响
- 关键转折(如果有)
这不是 CRM,是真正的「我理解这个人」。
第二件:patterns/ 和 tensions/ 目录
我的知识库里没有这两类内容的专门位置:
- patterns(行为模式):我在遇到不确定时的典型反应、我如何判断一个项目值不值得继续、我在被催的时候会做什么
- tensions(内在矛盾):商业化速度 vs 产品完整性、个人表达 vs 受众期望、执行力 vs 探索欲
这些内容不会从某篇 worklog 里自然涌现。但它们是最能预测我未来行为的内容。每季度主动提炼一次,是很值得的投入。
第三件:知识卡片的「模式识别层」
我每读一篇文章,都会生成一张知识卡片。这些卡片是孤立的。
现在计划:每 10 张卡片做一次合并——「这 10 篇在讲同一件事吗?核心洞见是什么?有没有相互矛盾的地方?」把结论存成一篇 patterns/ 文章。
这让知识卡片从「读了就放着」变成了「真的在积累认知」。
和 AI 结合的关键
wiki skill 本身是给 Claude Code 设计的——用 /wiki absorb 这样的命令触发,Claude 读 entries,写文章,管理 backlinks。
但这件事的本质不是工具,是工作流:
有人(或 AI)定期把原始记录「读懂」,然后更新已有的理解文章。
我的实践版本是:
日常:继续用现有系统捕获(worklog / 知识卡片 / LifeOS 事件)

每月(人工 + AI 协作):
  1. ts search "[某人/某主题]" → 拉出所有相关记录
  2. 把记录喂给 Claude + 说明 wiki 写作规范
  3. Claude 写合并理解文章
  4. 我审阅修改
  5. 存入 vault/space/crafted/people/ 或 patterns/

每季度:
  提炼行为模式和内在矛盾
更新 patterns/ 和 tensions/ 目录这不是全自动的,也不应该全自动。理解这件事,需要人参与。AI 负责初稿和关联发现,人负责确认「这真的是我的理解」。
为什么不直接用他的那套
说实话,farzaa 的方案我没有完整照搬,原因有三:
一、他的方案假设你有大量历史原始数据 适合「我有 3 年的 Day One 日记,想整理成知识库」的场景。我的系统是 daily-driven 的,每天在产出,不是批量整理历史数据。
二、他的系统没有行动层 wiki 是很好的知识存储,但他的方案里没有「从知识到行动」的机制。我的知识库有 actions.json、habit 打卡、LifeOS 决策——我需要的不只是「我理解了什么」,还有「我因此做了什么」。
三、基础设施问题 他的方案是「把 SKILL.md 放进 Claude Code 项目」就能跑。我已经有 ThirdSpace CLI 和 vault 结构,另起炉灶成本太高,也没必要。借鉴思想,不照搬工具。
总结
知识管理有两种截然不同的目标:
A. 永远找得到(档案柜目标):只要存进去,以后能搜到就行。
B. 真的理解(头脑地图目标):存的东西被消化,连接成网,能帮你做出更好的判断。
大多数知识管理系统,包括三年前的我,都在追求 A。
farzaa 这个 skill 提醒的是:光能「找到」还不够。知识库真正的价值,在于它有多接近你真实的思维方式。
我现在的计划:保留现有系统(捕获效率很高),在上面叠加一层「定期理解」的工作流。每月一次人物合并,每季度一次模式提炼。
不需要重建,只需要加一个习惯:定期把存进去的东西读懂,然后重新写出来。
ThirdSpace 是我用来管理个人知识库的工具,已开源:github.com/zzyong24/thirdspace wiki skill 原文:https://gist.github.com/farzaa/c35ac0cfbeb957788650e36aabea836d