· 月明Verse · Agent 协作 · 6 分钟阅读
Agent 最危险的不是不会做,而是把已有系统重做一遍
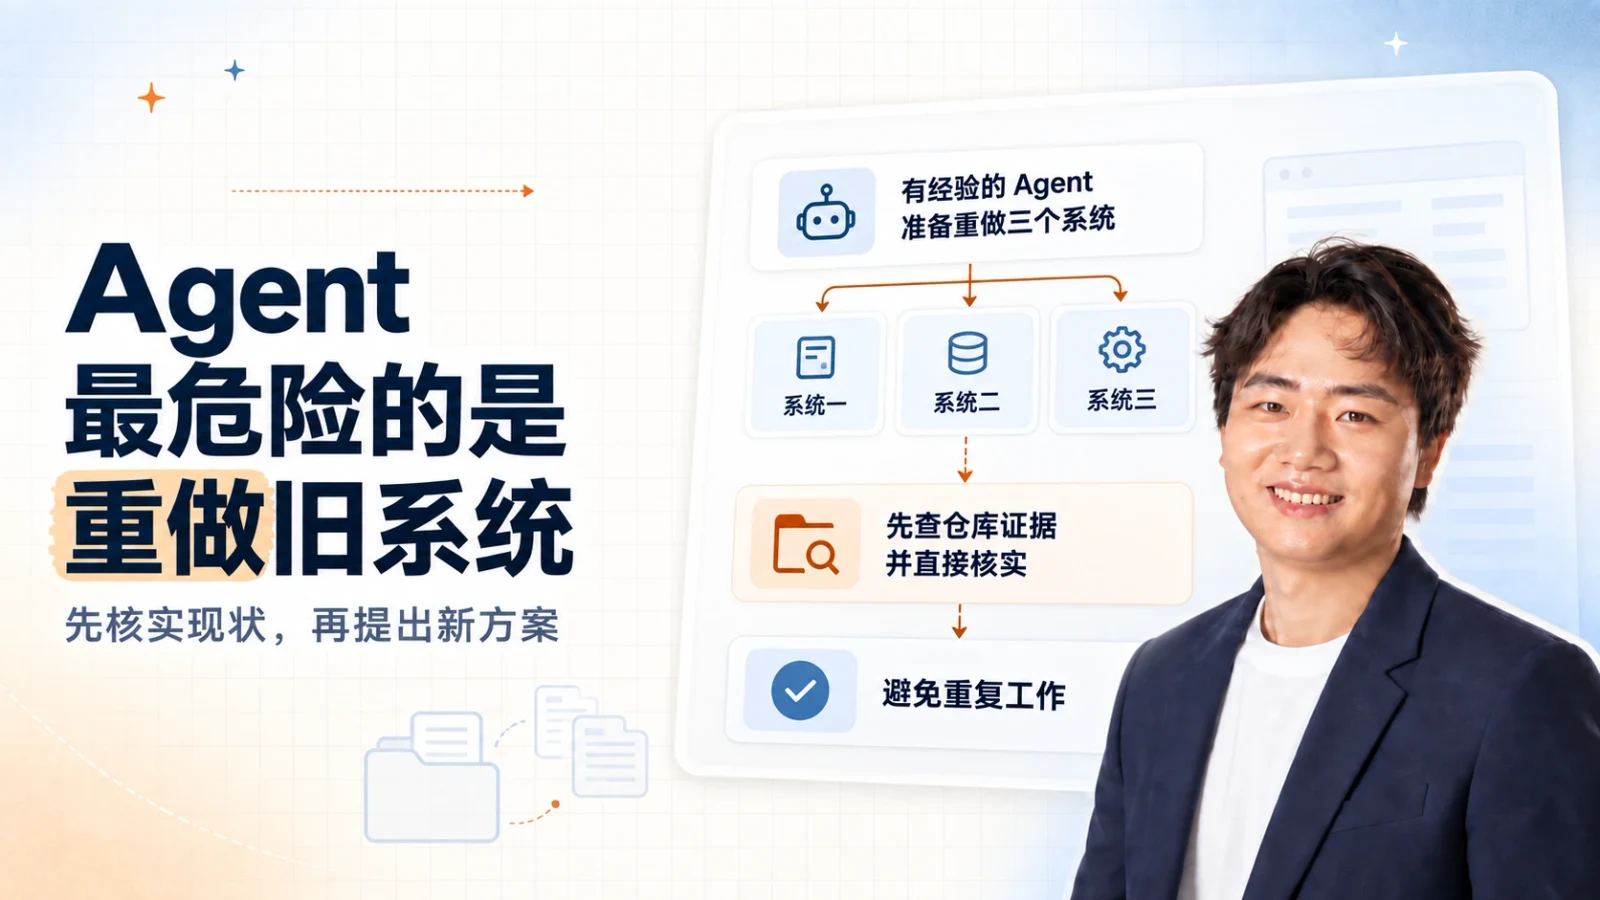
我在一轮迭代里三次差点让 Agent 重造已经存在的能力。代码库越成熟,AI 越容易高估缺口;解决它的关键不是更强模型,而是先反证、再开工。
我最近在一个已经完成 200 多个任务的成熟项目里做迭代。
一轮下来,Agent 三次告诉我:
- 这个子系统还没有,需要新建;
- 这个节点是孤儿,没有 runner;
- 这条数据回填链路还没接。
三次都错了。
如果我照着它的结论直接开工,就会把已经存在的系统重新做一遍。
第一次:六个任务,其实只需要两个适配器
我要做一次联网搜索解耦。
Agent 扫完代码后给出的方案,是新建检索抽象层、provider 工厂、解析层、配置卡和装配逻辑,一共拆成六个切片。
方案写得很完整,甚至通过了另一模型的 spec review。
开工前我多做了一次代码检索,才发现:
检索工厂、三个 provider 适配器、解析层、装配逻辑、设置页配置卡,半年前就已经建好了。真正缺的,只是增加两个免 key 的适配器。
一个“重造子系统”的项目,瞬间缩成两个增量改动。
第二次:所谓孤儿节点,全链路早已接通
Agent 判断一个“论点树生成节点”没有 runner,是孤儿能力。
我继续查符号定义、调用者和调度入口,发现模板、runner、触发按钮、采纳分支全都已经存在。
它不是没认真搜索,而是大型代码库里的探索天然是抽样式的。只要漏掉一个装配点,Agent 就会从“我没有找到”跳到“它不存在”。
最危险的是,它给结论时往往语气非常确定。
第三次:通过评审的 spec,现状仍然可能是错的
很多人会觉得,多找一个模型评审 spec 就稳了。
但评审模型审的是:
- 方向是否合理;
- 方案是否自洽;
- 有没有违反产品定位。
它不会自动去证明“代码里是不是已经有了”。
如果 spec 的现状章节来自一次不完整的扫描,那么再聪明的评审,也只是在错误前提上做正确推理。
所以我后来给 spec 加了一条硬规则:
“现网已经有什么、还缺什么”的每条断言,都要带文件位置或调用证据。
成熟代码库要反过来假设
新项目里,可以默认某个能力还不存在。
成熟项目里,默认值应该反过来:
我想加的能力,多半已经有雏形;先去证伪,再决定新建。
只要 Agent 出现这些词,我就会停下来复核:
- “需要新建”;
- “没有实现”;
- “孤儿节点”;
- “尚未接入”;
- “缺少完整链路”。
复核也不复杂:
- 搜符号定义;
- 搜所有调用者;
- 查装配根、路由或调度器;
- 查测试和真实入口;
- 最后才判断缺口。
子代理的地图是线索,不是事实
多 Agent 特别适合做宽搜和测绘,但它们给出的“全绿”“缺失”“已经完成”都不应该直接成为结论。
主 Agent 仍然要看真实文件、真实调用和真实运行结果。
这不是不信任 AI,而是承认一种结构性限制:每个 Agent 都只看到了有限上下文,而成熟系统的真相经常藏在跨目录、跨模块和跨历史决策里。
最后一个教训:用户给的根因也要验证
同一轮里还有两个问题:
- “必须配置某个模型才能联网”;
- “审核一直转圈,是不是没配模型”。
真正根因分别是:
- 现有搜索 provider 都需要付费 key,缺免 key 路径;
- 模型调用没有超时,端点挂起后会永远等待。
用户报告的症状是真实的,但对根因的判断仍然只是线索。
这也适用于 Agent。
当代码库变复杂以后,最值钱的能力不是马上给方案,而是先问一句:
这个结论,我有没有用真实代码反证过?
很多“高难度重构”,会在这一步直接消失。