· 月明Verse · AI 产品观察 · 20 分钟阅读
Personal AI 的入口之争
从个人记忆、设备算力和服务连接,讨论个人 AI 入口为什么难以形成。
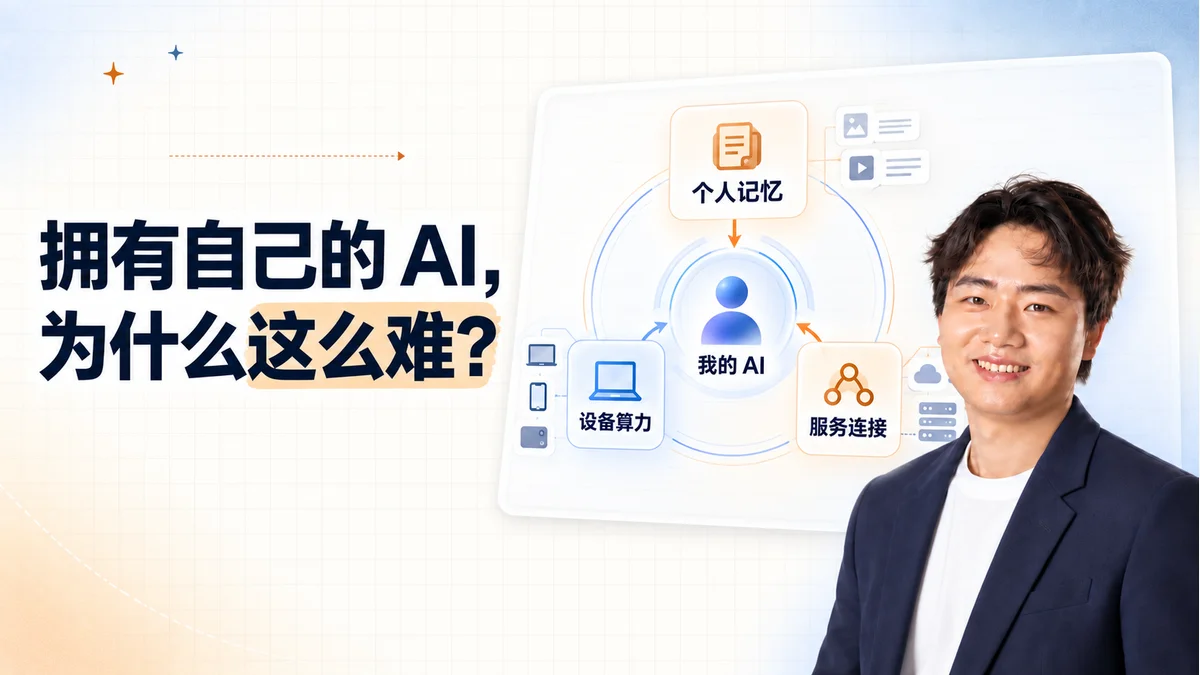
谁都渴望拥有一个自己的数字分身。
不用每次介绍自己,它就知道你正在做什么、习惯是什么、为什么事情烦恼。昨天讨论到一半的项目,今天可以接着往下做;随口提过的想法,过几天它还能帮你找回来。
我们已经有了能写文章、写代码、分析资料的 AI。可一回到自己的生活,还是得先花时间把前情交代一遍。换一个应用、开一个新会话,又要从头说起。
为什么一个能回答那么多问题的 AI,偏偏很难长期懂得一个具体的人?
谈这个问题,我想先从今年 3 月的一次交流说起。
Alice 描述的未来,远远超出一个聊天助手
今年 3 月,我在抖音上发过一篇关于数据主权的文章。很荣幸,Jason 大佬给我点了赞,还分享了他在 2023 年关于 Alice 的思考和见解。
沿着这些思考去读 Alice 的宣言,我看到了一种个人 AI 的架构,也看到了一种互联网可能走向的未来。
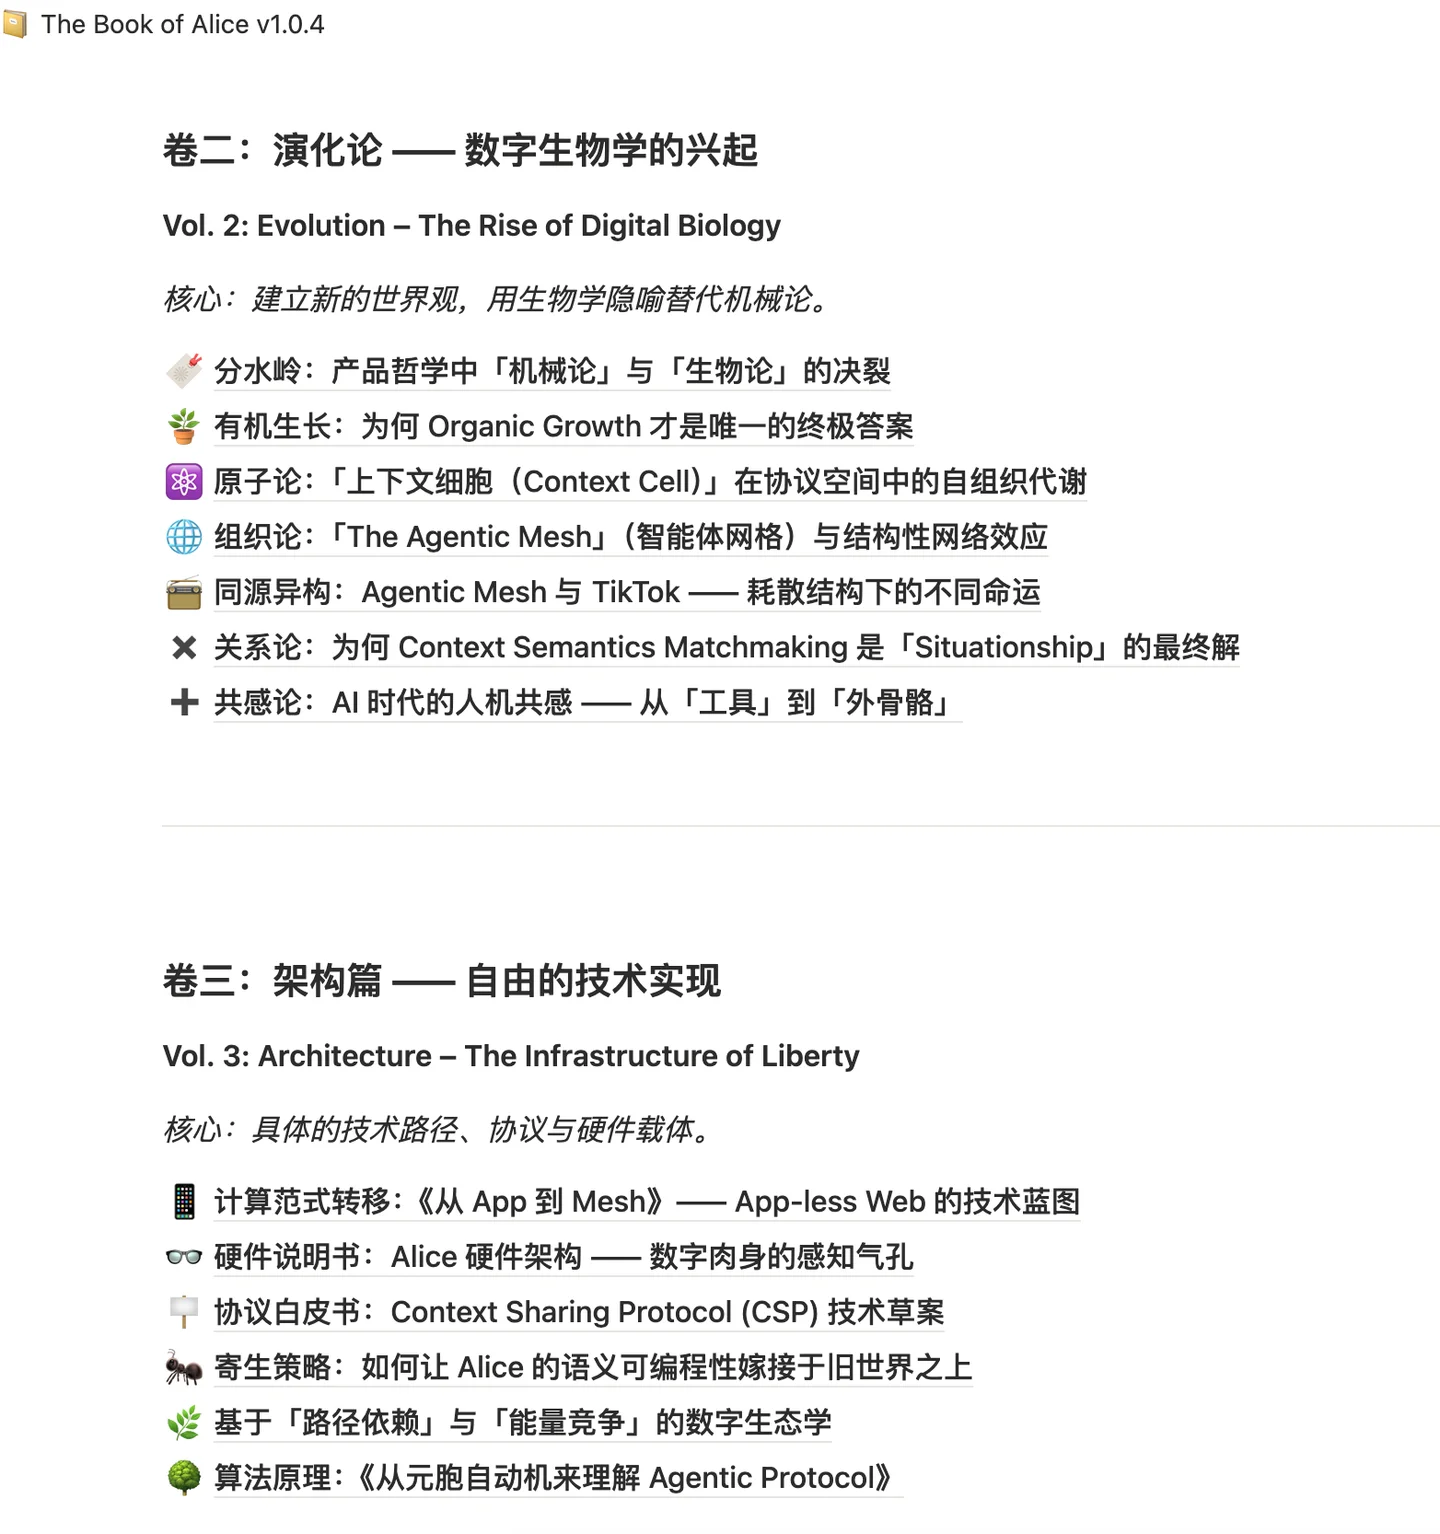
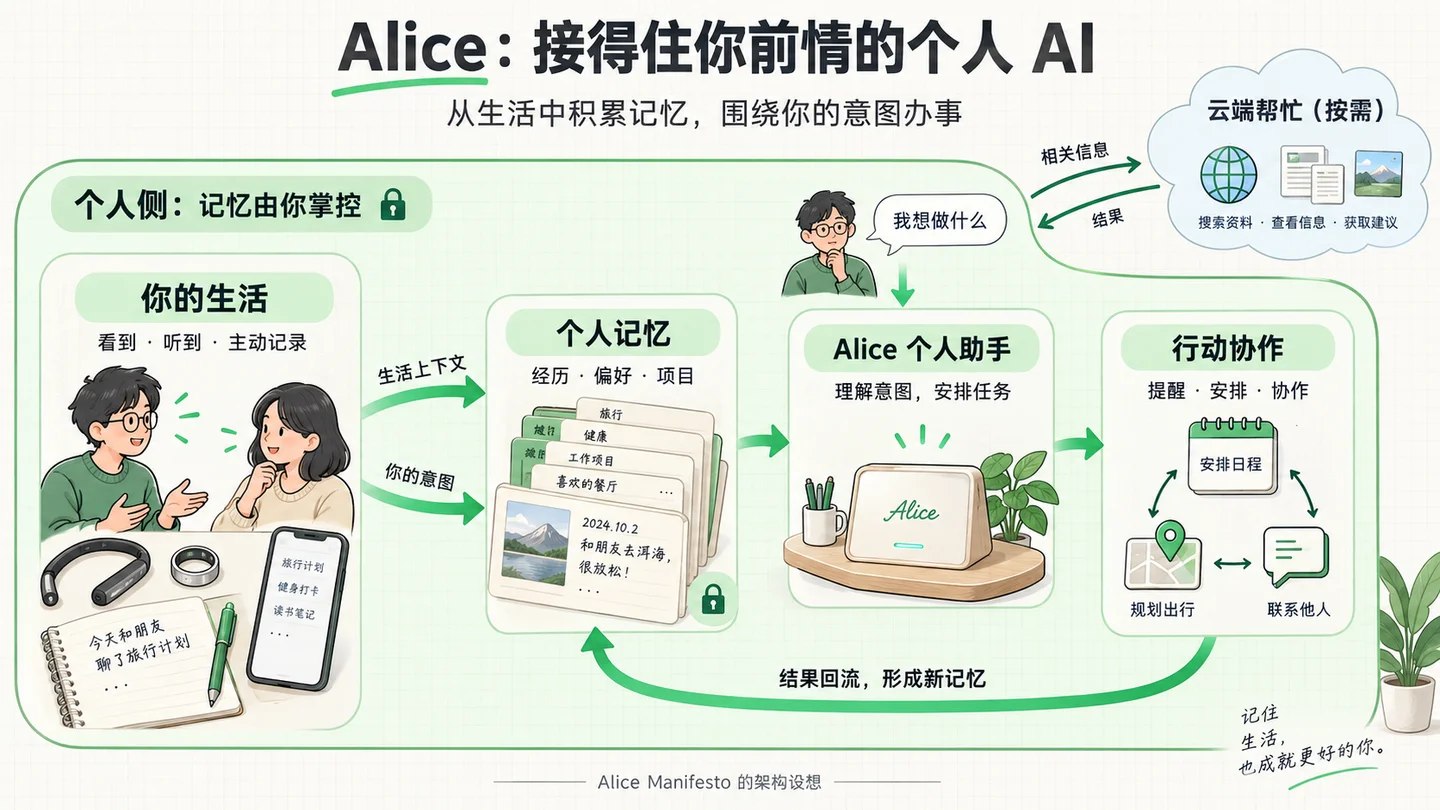
仅从这份目录,就能看到它思考的跨度:上下文如何组织,智能体如何连接,人机如何共感,再到硬件、协议,以及“从 App 到 Mesh”的互联网架构。一个人的 AI 怎么成长,又怎么带着这个人的意图去连接外部服务,这些问题被放在一起讨论。
在这个未来里,AI 从你的所见所闻中获取上下文。一次讨论、一场会议、一个临时想到的点子,都能进入你自己的记忆系统。它逐渐知道你正在推进哪些事情,哪些偏好会影响决定,哪些烦恼还没有解决。
这些记忆保存在个人侧。日常任务用本地算力处理,遇到复杂问题,再带着相关上下文向云端借用算力。你不必为了每一次回答,把自己的生活重新讲一遍。
但 Alice 的思考还往前走了一步:服务可以围绕人的意图组织起来。
比如你想安排一次出行。现在,你要自己找攻略、查交通、看日历、比较住宿,把不同应用里的条件拼起来。在那个愿景里,个人 AI 带着你的时间安排、预算和偏好,去连接需要的服务,帮助你把这件事做成。
宣言里有一句话:
下一代互联网不应致力于消耗人类的时间,而应致力于完成人类的意图。
这句话把评价互联网的尺度推向了另一边:一个服务帮助你完成了多少事情,替你省下了多少时间?如果你能办完事就离开,产品也应该因此获得价值。
而当 AI 开始陪着你生活、替你处理事情,它就成了一个人的“数字外脑”。这里又出现一个更长远的问题:你的记忆和选择权,究竟掌握在谁手里?
在 Alice 的设想中,你的偏好、生活轨迹和长期记忆,由你掌握。不能因为一个账号被封、一家公司停止服务,这些前情就跟着消失。你也应该能够决定谁来读取它们、如何使用它们。
这就是我觉得这篇文章高瞻远瞩的地方。它已经在思考:当 AI 成为生活的一部分,人怎样继续掌握自己的人生。
本地模型已经够用,前情却接不上
要走到那个未来,有个问题绕不开:我们能不能拥有自己的数据,也就是自己的 Context——上下文。
前几个月,大家都在搭自己的 AI 大脑、个人知识库、个人工作台。名字各不相同,背后那个愿望很清晰:把散落在不同地方的信息汇聚起来,把自己的工作流串起来。
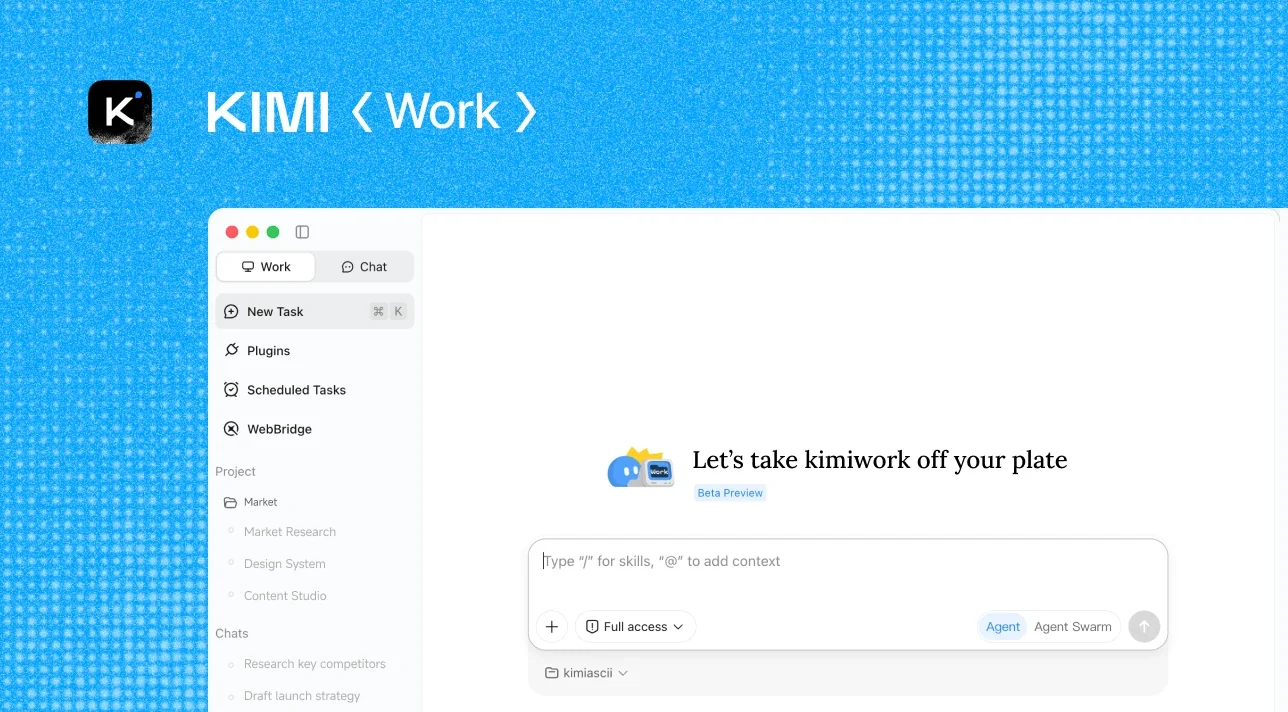
在 Kimi Work 的界面里,可以看到项目、任务、插件这些入口。一次对话开始和一项工作往下推进,被放在了同一个工作台里。
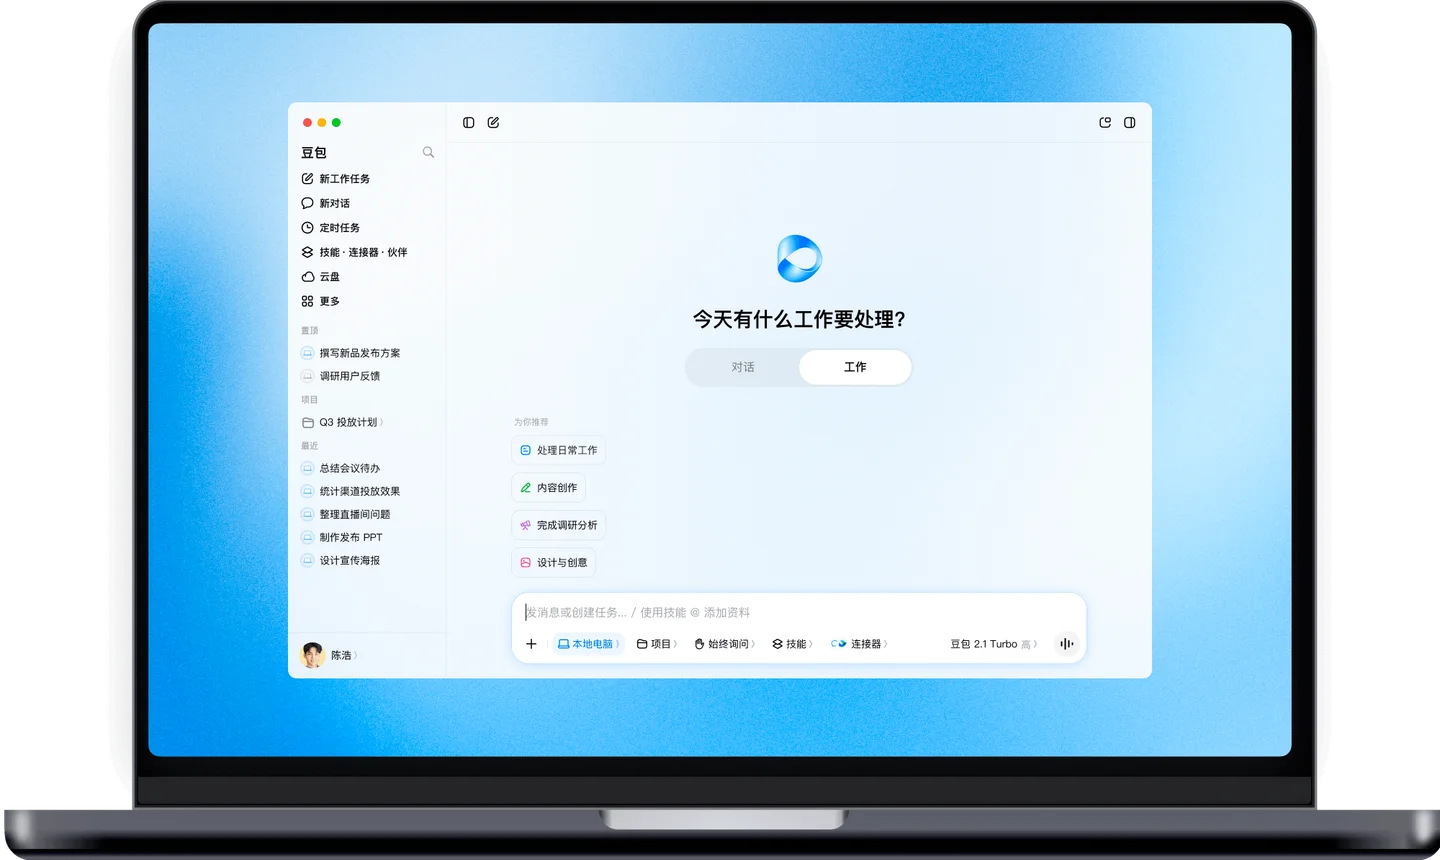
豆包的工作模式里,也能看到工作任务、项目、云盘和连接器。我们想让 AI 带着资料做事情,产品也在尝试把这些入口接到一起。
可一放到生活里,就知道这件事有多麻烦。
比如约朋友吃饭。朋友在微信里说过不喜欢牛排,空闲时间在日历里,选店要看点评,距离要看地图。单独打开其中任何一个应用,都只看得到一部分条件。
现在,各个 App 都开始有自己的 AI 助手。但你在上一个 App 里讨论的结果,到了下一个,还是得重新讲一遍。餐厅助手可以给你推荐热门店,却未必知道朋友的忌口;地图可以规划路线,却未必知道你们几点才有空。
于是,负责把这些信息拼起来的,仍然是你。
我在本地部署过千问的 9B 模型,也部署过谷歌的 Gemma 4。在日常对话中,它们能给出不逊色于云端通用模型的回答。按我的体验,日常 80% 的场景,端侧模型已经能应付。
这意味着,日常任务可以先在自己的设备上处理。 围绕一份资料做问答、讨论一个想法、整理已经提供的信息,不一定每次都要调用最强的云端模型。
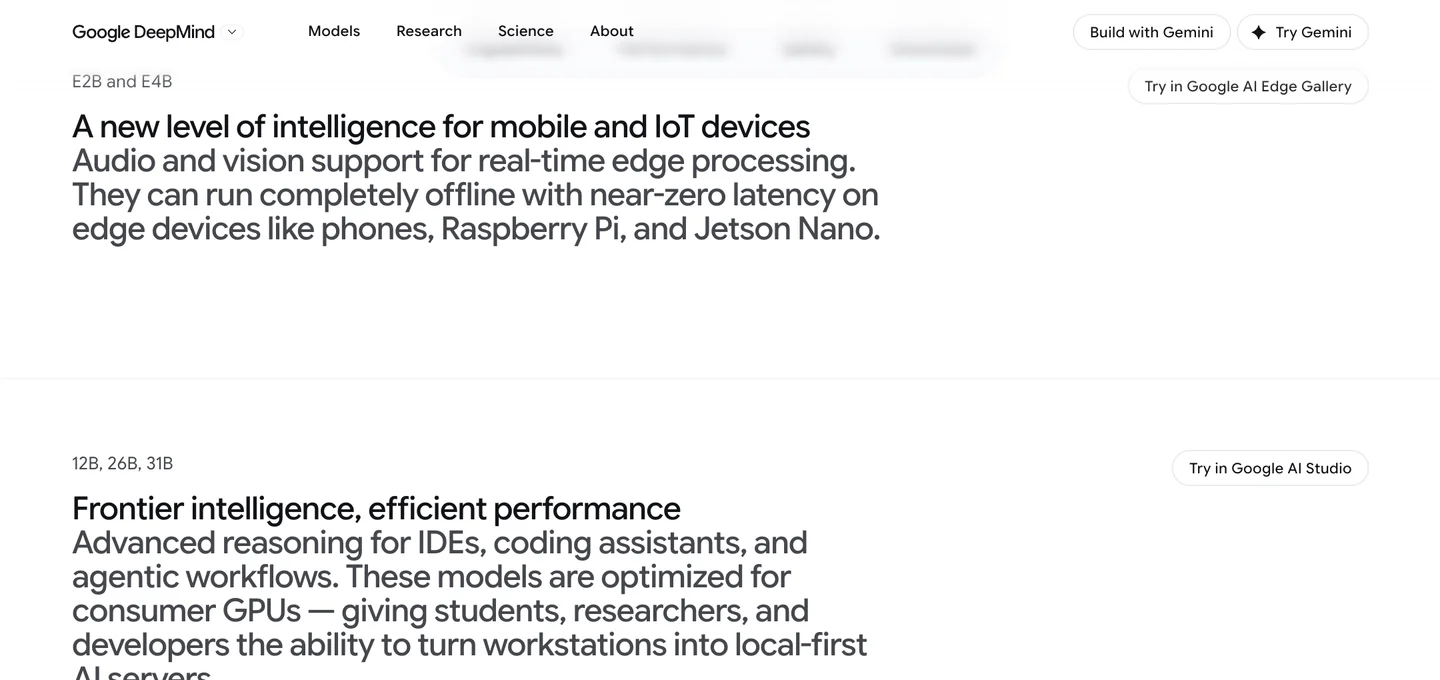
谷歌对 Gemma 4 的官方介绍也给出了这条路线:E2B、E4B 可以在手机等端侧设备上完全离线运行,较大的模型则面向个人电脑和消费级显卡。
本地模型能用以后,个人 AI 的另一个难题就显出来了:它拿到了什么?你把一份资料交给它,它可以围绕资料回答;你想让它帮你做一个生活决定,它就需要知道那些没有写进这次提问里的条件。
可你问它“今晚去哪吃”,它不知道你昨天说过什么,也不知道朋友的忌口。即使模型能列出十家餐厅,也缺少判断哪一家适合你们的前情。
工作中也是如此。你昨天为什么否掉一个方案,今天为什么改了项目方向,哪些条件已经谈妥,哪些事情还在等回复,都影响下一步应该怎么做。只放进去一堆文件,还没有把这些正在发生的变化接起来。
一个长期懂你的 AI,需要持续积累前情,才能把通用能力用到你的具体生活里。
你的上下文,也是平台的生意
这些前情,正散落在不同平台手里。
对我们来说,它们是聊天记录、消费习惯、出行轨迹和工作资料。对平台来说,这些数据也有商业价值:可以用来理解用户、做推荐、经营广告和交易。
假如一个个人 AI 能直接替你筛选、比较、做决定,很多事情的入口就可能发生变化。你想买一件东西,可以先把需求交给自己的 AI,让它去比较,再把结果带回来。原来需要你停留、浏览和反复切换的过程,就有可能缩短。
所以,即使模型已经有能力处理这些信息,平台愿不愿意把信息交给你的 AI,依然是另一道门。这里牵涉平台怎样获得收入、怎样维持用户关系,也牵涉谁来负责连接后的权限和使用方式。
WeFlow 删库:记忆的入口能用多久?
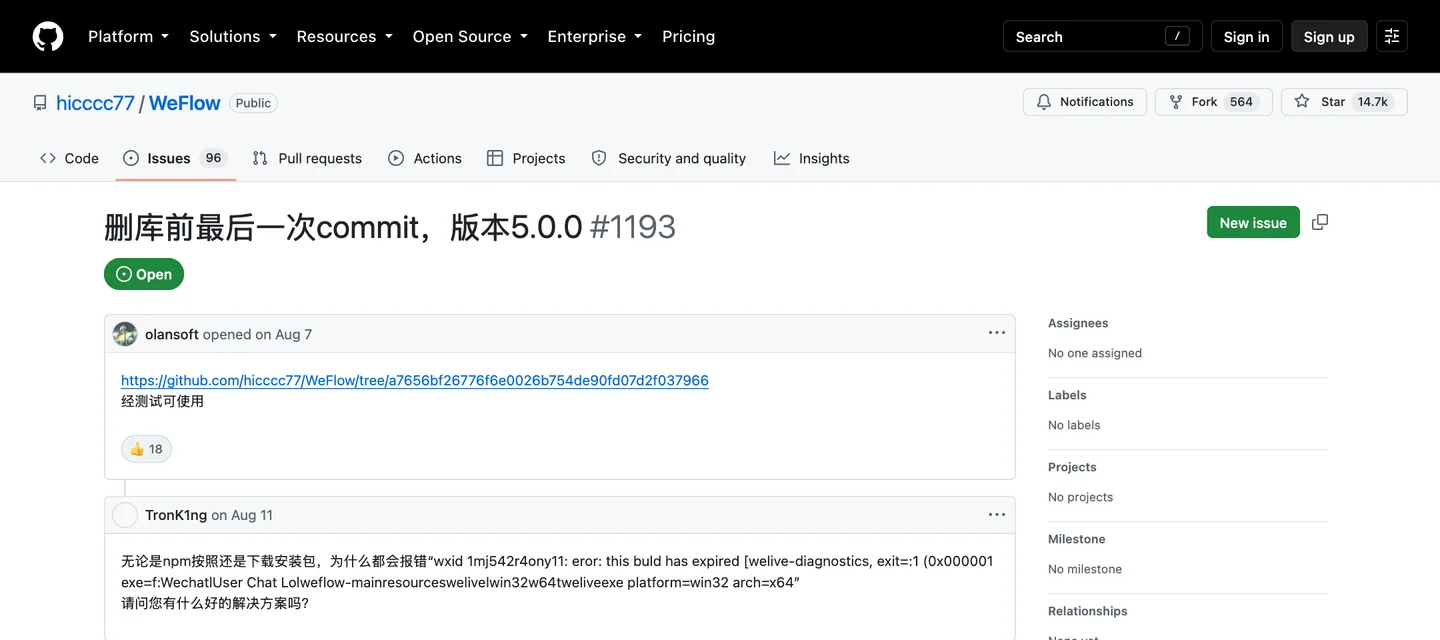
前段时间,WeFlow 这个提取、查看和导出微信聊天记录的开源客户端,就经历过删库。
项目的历史讨论里,还留下了“删库前最后一次 commit”的记录。
聊天记录里,有我们做过的决定、讨论过的项目,也有与朋友来往的前情。把它们带进自己的记忆系统,个人 AI 才能知道一件事是怎样发展到今天的。
但当获取这些记录的工具中断,你就得重新找办法,把后续的前情接进来。对于一个要长期懂你的 AI,能导出一次记录,还不足以支撑几年、十几年的记忆积累。
Jev 停止微信支持:会给建议,仍可能接不到对话
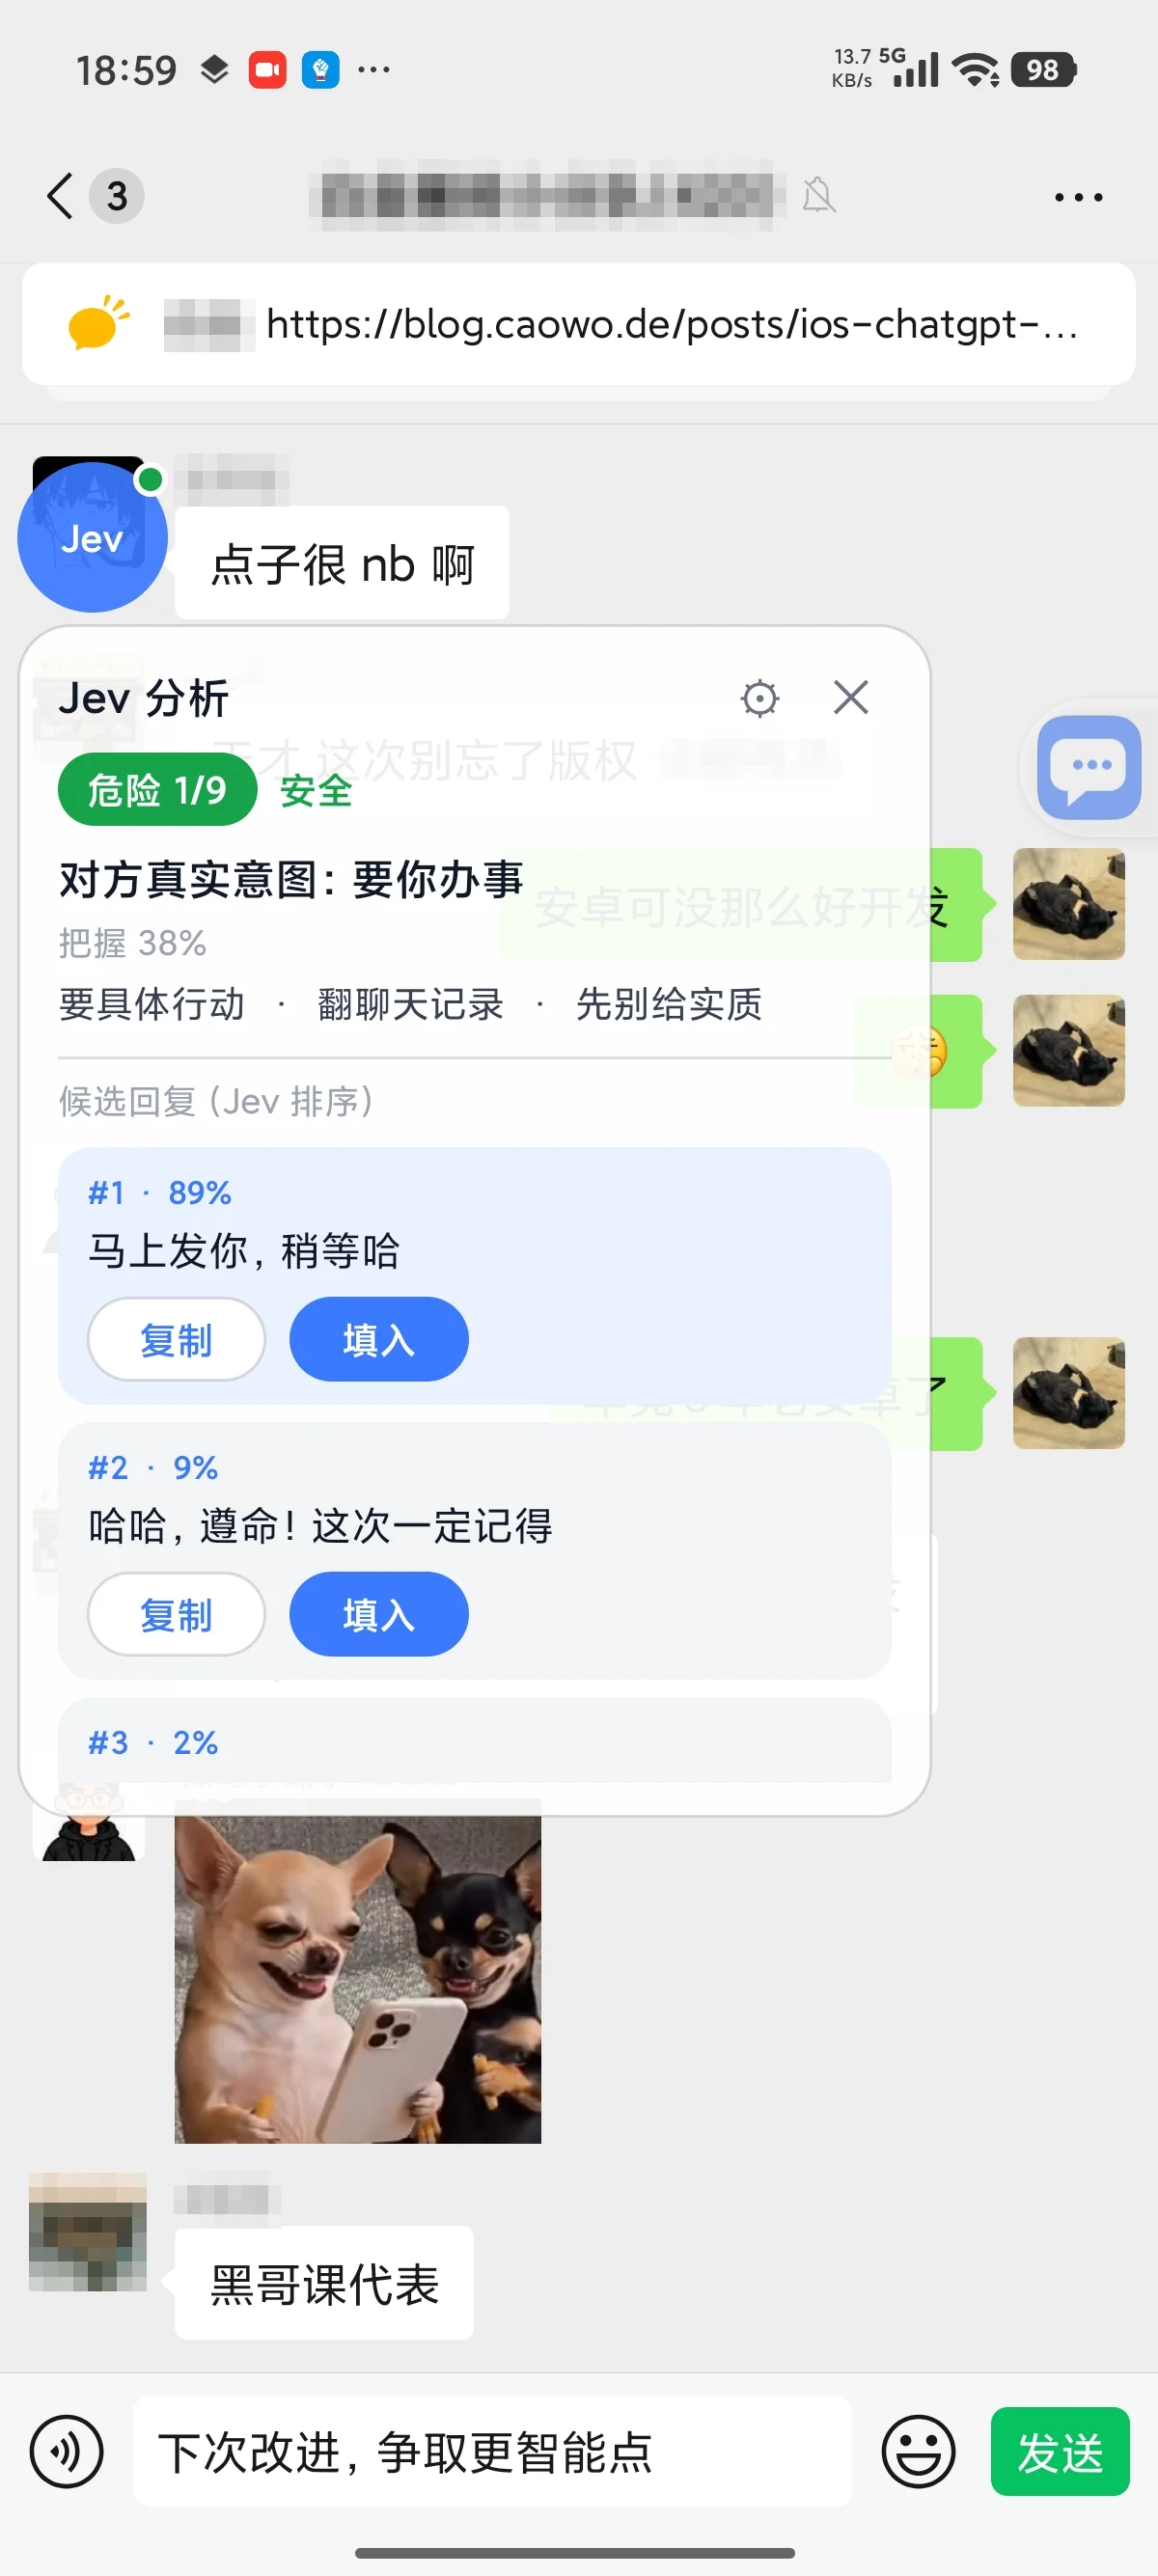
我之前也发过 Jev 聊天助手,它会结合当前对话给出候选回复。你可以从下面的历史演示里看到,它把建议放在聊天界面旁边,供你选择。
后来,它的 Android 版停止了微信支持,不再采集或处理微信内容。 项目保留的说明截图里,写出了这个变化。
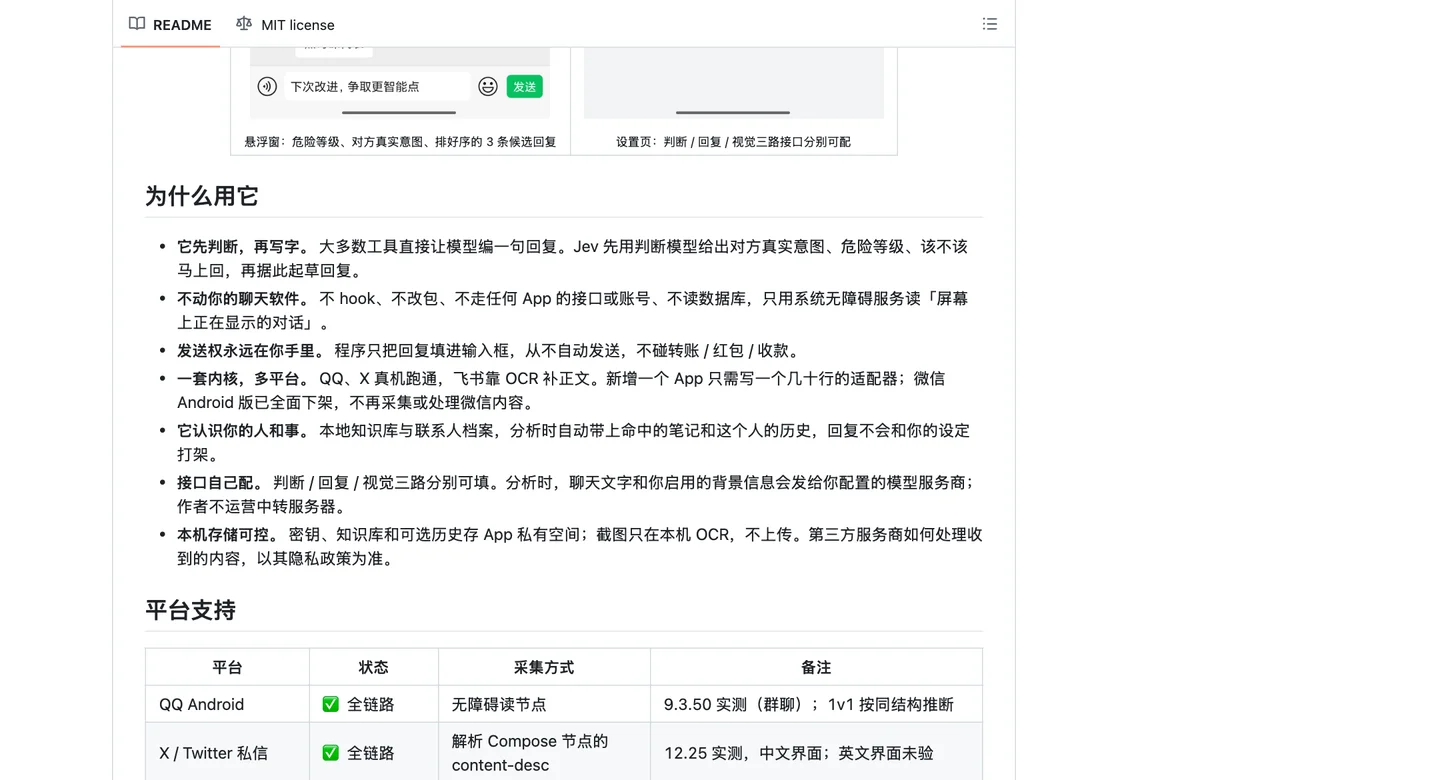
这种变化会直接影响助手能帮到哪里。即使它能理解一段对话、给出合适的回复,只要接不到微信里的前情,能力就用不到这个具体场景里。类似尝试,又碰到了大家说的“神秘力量”。
Muse 被亚马逊拦住:有购物能力,也可能进不了商店
类似的冲突,也发生在大公司的个人 AI 身上。
2026 年 9 月 20 日,GeekWire 报道,亚马逊已经阻止 Meta 的 Muse 代表用户在 Amazon.com 购物。用户让 Muse 去购物时,会看到亚马逊关于“未经授权的 AI 代理”访问的拦截提示。
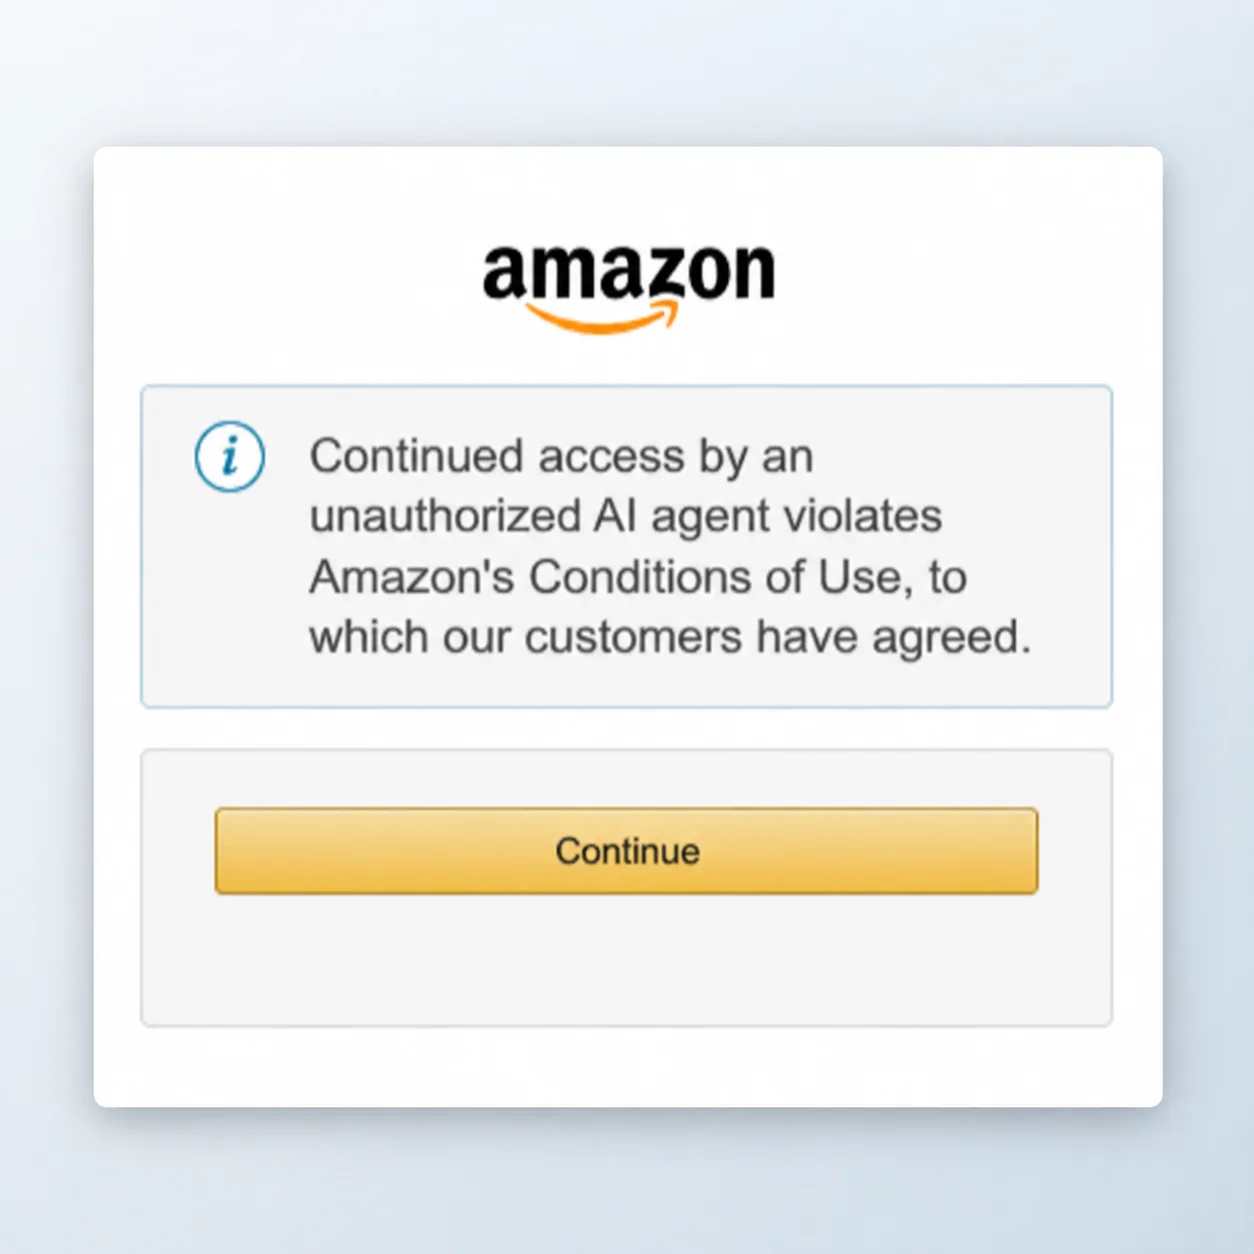
亚马逊给出的理由涉及事先同意、代理身份和用户账号安全;它要求第三方代理尊重服务提供方是否参与的决定。
这让“我的 AI 帮我办事”遇到了另一层现实:用户愿意让助手代办,平台也可能拒绝这个助手。一个助手能比较商品、理解需求、执行购物流程,并不意味着每家商店都会向它开放。
在我看来,这里还牵涉谁来掌握用户关系和购买入口。原来你在平台里浏览、比较、接受推荐;如果改成个人 AI 先替你筛选,再把决定带回给你,平台与用户之间的关系就会变化。
先把其他争论放一边,单看个人 AI,这里有个很现实的问题:你的助手今天能接到一段前情,明天这个入口还在不在?
WeFlow 和 Jev 让我们看到上下文连接的难处,Muse 则让我们看到跨平台行动的难处。一个要长期懂你的助手,需要持续积累前情,也需要在你授权后把事情做下去。如果入口随时可能中断,记忆和行动都很难连续。
从今天开始,把记忆留在自己这里
那还有什么方向可以尝试?
我会想到眼镜、录音设备这样的入口。从自己看到、听到、主动记录的生活信息开始,让今天产生的前情先在自己这里留下来。
比如一次会议结束,讨论里的决定、待办和没有解决的问题,能进入个人记忆。下一次继续推进这个项目时,AI 可以带着这些前情来帮你,而不用等你重新整理一遍会议发生了什么。
沿着这个方向,端侧、本地和云端可以有一套协作方式。
手机、眼镜这样的端侧设备,贴近生活发生的地方,负责获取你选择记录的信息,也处理即时的简单任务。电脑或个人服务器可以保存长期记忆,把项目、日程和资料接起来,处理日常工作。
遇到需要更多算力的问题,再把这次任务需要的上下文交给云端。云端处理完,结果回到个人侧,经过你的确认进入后续行动;事情做到了哪一步,也继续留在记忆里。
这样,一次讨论才能接到一个决定,一个决定才能接到后面的行动。下次再遇到相关事情,AI 知道上次的结果,不必每次都从零开始。
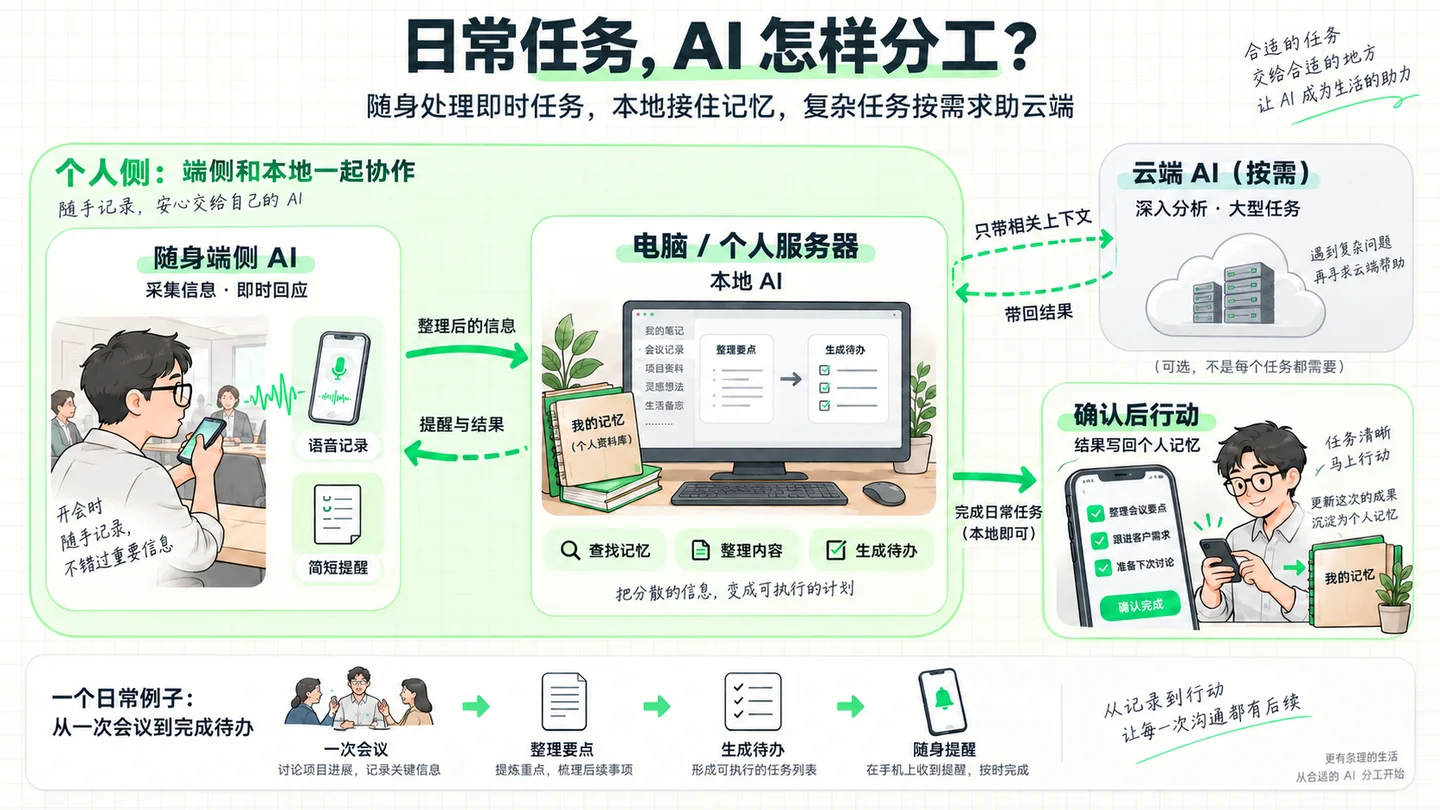
平台里已有的历史数据,依然需要找到连接的办法。但我们可以先让今天的一次会议、一个想法、一段项目进展,成为自己能够保存和继续使用的记忆。
从使用 AI,到拥有自己的 AI
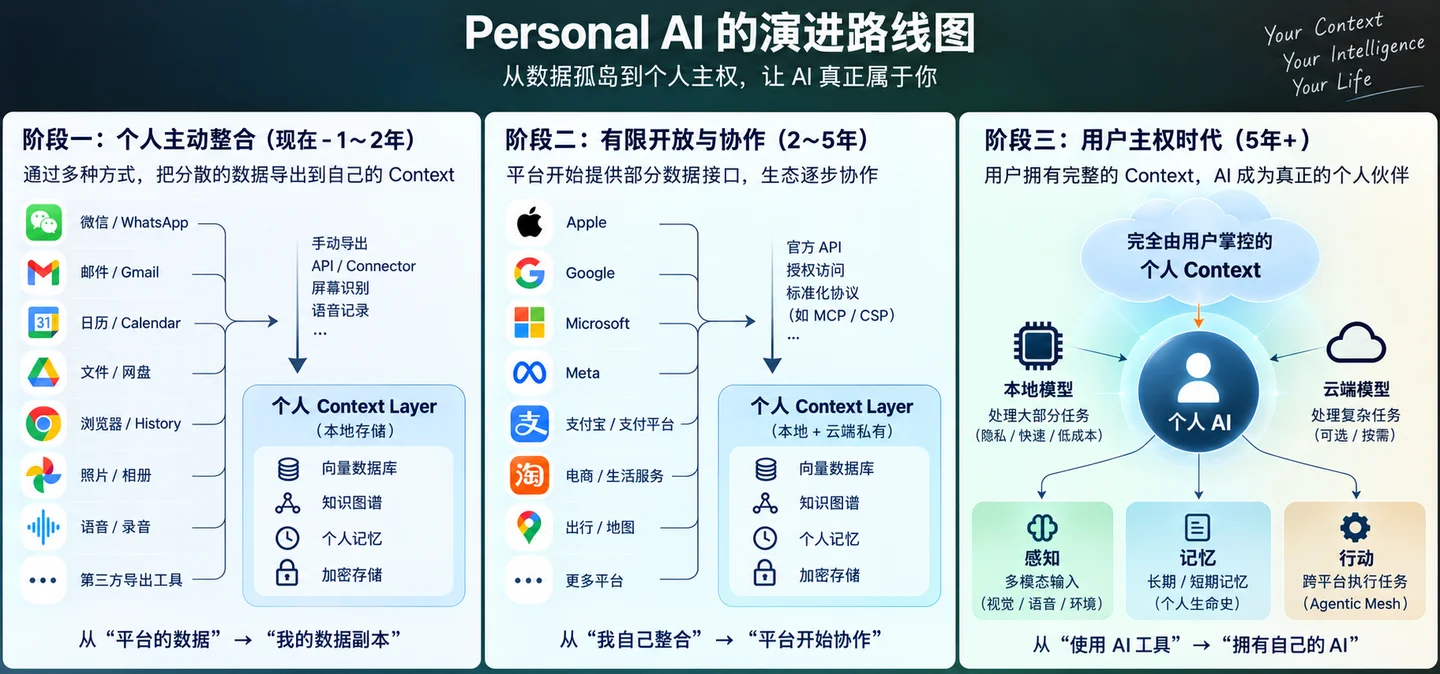
我会把这条演进路径分成三个阶段。
现在,我们先由个人主动整合:导出聊天记录、整理笔记、连接日历和文件,把分散的信息带到自己的上下文系统里。这个阶段,很多工作还得靠自己做,先得到一份自己能使用的数据副本。
往后,如果平台开始提供更多授权接口,不同服务愿意协作,个人 AI 就能稳定地带着上下文处理跨平台任务。我们也不用为了串起一件事,反复在几个应用里搬运信息。
继续走下去,用户能够掌控自己的上下文,选择需要的模型和服务。模型可以换,服务可以换,陪着你积累下来的记忆仍然跟着你。个人 AI 才能从一个随时需要重新介绍自己的工具,成为持续理解你的人生的伙伴。
回到今年 3 月读到的那个愿景,我们都希望生活中的每一个瞬间,都有一个懂自己的助手能够回应。
这件事很难,因为它需要接住生活的连续性:昨天的决定会影响今天,今天发生的事又会成为明天的前情。模型、采集设备、记忆系统和服务连接,都需要围绕同一个人的生活协作。
要走到那里,我们得有办法积累自己的记忆,也得有权决定谁能读取、怎么使用。
等 AI 接住了我的生活,我希望这些前情,也能一直跟着我。
—— 月明水清深