· 月明Verse · AI 工程 · 8 分钟阅读
AI 写代码为什么越写越烂:我用编排器对抗 Vibe Coding 的熵增
一个项目有 25 个模块、76 个接口、1556 个前端测试,为什么还是越写越乱?我用 CreatorOS 的真实数据拆开 Vibe Coding 的熵增,并给出一套可执行的工程化解法。
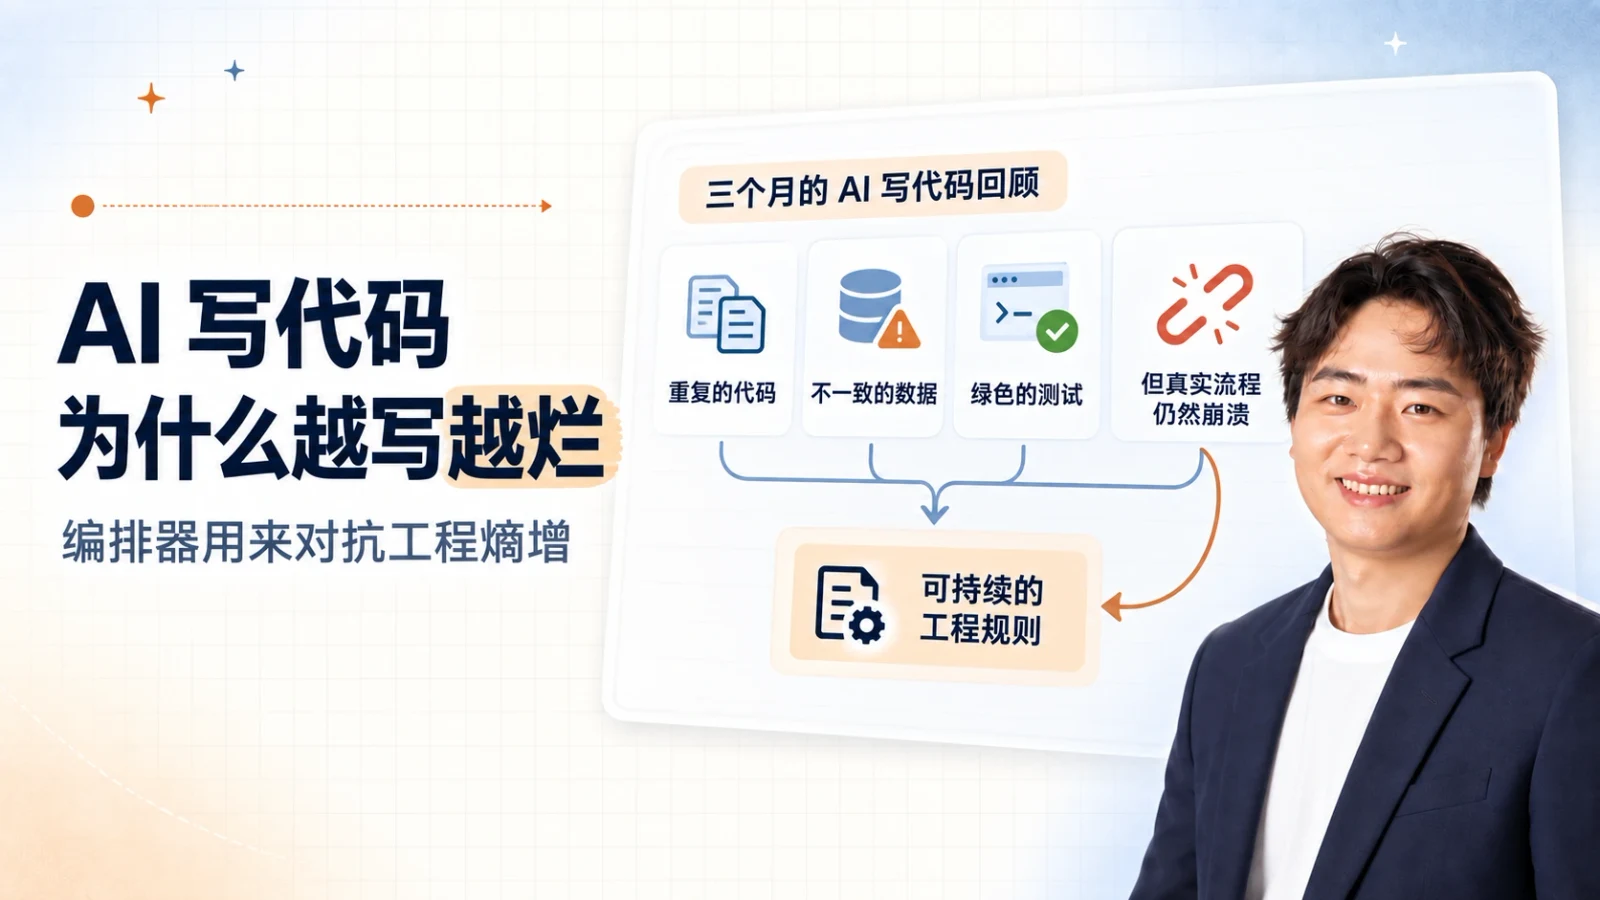
我用 AI 连续写了三个月代码之后,拿到过一组很漂亮的数字:
- 25 个后端业务模块;
- 76 个 contract endpoint;
- 1556 个前端测试;
- 跨模块 service 直接 import 为 0;
- 80 条真实踩坑记录。
如果只看这些数字,项目似乎很健康。
但我真正接手复盘时,发现系统里同时存在三代数据、几十个应该复用却被重复手写的组件,还有测试全绿、用户却根本走不通的业务路径。
更讽刺的是:80 条踩坑记录,真正回流成“下次不能再犯”的工程纪律,只有 3 条。
这就是我后来理解的 Vibe Coding 熵增。
不是 AI 变笨了,是系统没有记忆
很多人会把问题归因成模型不够强:
效果不好就换更大的模型,代码不稳就多写几条 prompt。
但项目里的腐烂,往往不是模型能力问题,而是开发方式的问题。
每一次对话里,AI 都能做出一个局部正确的答案。可当对话结束、上下文压缩、另一个 Agent 接手时,上一轮“为什么这么设计”的理由就消失了。
AI 看得见代码,却不天然拥有整个产品的心智模型。
它会优先选择这次最容易跑通的路径:
- 页面需要一个 service,就在页面旁边新建;
- 已有能力没搜到,就再造一套;
- 测试需要数据,就放一组 fixture;
- 两个页面需要相似组件,就各写一份;
- 功能看起来能点,就判断任务完成。
每一次决定单独看都合理,叠加三个月以后,项目就开始失控。
我在 CreatorOS 里看到的五种熵
1. 架构熵:代码默认长在调用方旁边
如果没有一张明确的“房子图纸”,AI 会把业务逻辑放在最靠近需求的目录里。前端页面要能力,后端逻辑就可能直接长进前端包。
它不是故意破坏架构,而是不知道谁拥有这个模块。
2. 数据熵:能 join,不等于语义正确
AI 很擅长生成“看起来像真的”数据。ID 类型能对上,字段也齐全,但真正运行时,引用可能指向不存在的版本,状态可能跨了错误的阶段。
类型正确只能证明结构没断,不能证明业务是真的。
3. 抽象熵:复制永远比抽公共组件快
AI 的本能是延续眼前范式。一个页面里已有一张卡,它更容易复制这张卡,而不是停下来判断“这是不是第二次出现的共享概念”。
所以重复会自然增长,抽象却不会自然出现。
4. 验证熵:局部全绿掩盖整体断裂
lint、typecheck、单测、build 都能通过,但用户仍可能无法完成一条完整任务。
因为测试验证的是切片,用户体验的是旅程。断点通常长在切片之间。
5. 认知熵:代码越来越多,人越来越不懂
当所有实现都交给 AI,人很容易只保留“它能跑”的印象,却没有建立“它为什么这样跑”的模型。
代码量在增长,团队对系统的理解却在下降。这种债不在仓库里,而在人脑里。
我后来不再让 Agent 直接从需求冲向代码
真正有效的改变,不是换模型,而是在模型外面补一套纪律。
我把工作流拆成五段:
- PLAN:先把目标、边界和不做什么写成一份 spec;
- CONTRACT:先确认数据和接口真的能兑现需求;
- DESIGN:页面、组件和数据绑定在写代码前说清;
- BUILD:按垂直切片实现,但每片都必须接真实路径;
- SHIP:从用户入口走完整旅程,而不是只看测试结果。
我把管这套控制流的东西叫 Orchestrator,把 prompt、文件系统、子代理、上下文和验证环境的完整封装叫 Harness。
名字不重要。重要的是:AI 不能只拿到任务,还要拿到边界、状态、验收方式和历史教训。
五个今天就能做的改变
如果你正在用 AI 写一个会长期维护的产品,不需要先造一套复杂平台。先做这五件事:
1. 给项目写一张真正的架构图
不是放在汇报里的图,而是明确到“哪个包拥有什么、哪些调用禁止发生”的执行规则。
2. 每个任务开工前先搜“它是不是已经存在”
成熟项目里,想加的能力多半已有雏形。先找定义、调用者和装配点,再决定要不要新建。
3. 把临时东西登记成债
fixture、mock、假按钮、占位页都可以存在,但必须有 owner、退役条件和销账时间。
4. 验收时至少走一条真实数据
不要永远用最完整的 demo 项目截图。真实用户、真实空值、真实失败路径,才能暴露产品问题。
5. 每隔一段时间做“整体正确性”审计
每完成十个左右的任务,停下来走一次核心旅程。检查跨页词汇、数据来源、写后能否读到,以及按钮到底有没有接线。
AI 带来的速度,必须配套更强的刹车
Vibe Coding 最大的价值,是让一个人拥有过去一个小团队的吞吐。
它最大的风险也在这里:人类团队里那种“大家天天使用产品,所以隐约知道哪里不对”的整体感,在多个 Agent 并行工作时几乎不存在。
速度越快,错误叠加得也越快。
所以我现在不再追求“让 AI 一口气写更多代码”,而是追求另一件事:
让每一次加速,都留下能被下一次复用的边界、证据和教训。
AI 写代码并不会天然让项目越来越好。只有当系统能够记住为什么、验证真实结果、主动阻止重复犯错时,速度才会真正变成复利。